The End of the GPU Era? AMD's Helios and OpenAI Strategy
Now Playing
The End of the GPU Era? AMD's Helios and OpenAI Strategy
Transcript
429 segments
قامت AMD بشيء لم تفعله
من قبل. لم تطلق مجرد
وحدة معالجة رسوميات (
GPU) أخرى. بل كشفت لنا
عن خادم ذكاء اصطناعي
متكامل. 72 وحدة معالجة
رسوميات، ومعالجات
مركزية، وشبكة خاصة،
صممت جميعها لتعمل
كآلة واحدة مترابطة.
أطلقوا عليه اسم "
هيليوس". وأصبحت هذه
القصة أكثر إثارة لأن
OpenAI تشتري "هيليوس"
بينما تعمل في الوقت
نفسه على تطوير شريحة
الذكاء الاصطناعي
الخاصة بها. للإجابة
على ذلك، نحتاج لفهم
ماهية نظام الرف (
Rack-scale) ولماذا قد تكون
الوصلات بين وحدات
المعالجة بنفس أهمية
الوحدات نفسها. لنبدأ.
تتفوق وحدة معالجة
الرسوميات في نوع واحد
من العمل، وهو تنفيذ
أعداد هائلة من
العمليات الحسابية
بالتوازي. وهذا بالضبط
ما يحتاجه الذكاء
الاصطناعي. لكن وحدة
معالجة واحدة لا تكفي
لتدريب النماذج
الرائدة أو لخدمة أكبر
الإصدارات لملايين
المستخدمين في آن واحد
. النماذج الرائدة
تعني ببساطة أكبر
نماذج الذكاء
الاصطناعي وأكثرها
قدرة يتم بناؤها اليوم
. نماذج مثل GPT و Gemini و
Claude. يمكن أن تصل إلى
مئات المليارات من
المعاملات، واستيعاب
كل ذلك، بالإضافة إلى
ذاكرة العمل المطلوبة
أثناء التشغيل، يتطلب
مساحة أكبر بكثير مما
توفره وحدة معالجة
واحدة. لذا، يتم تقسيم
أعباء العمل هذه عبر
العديد من وحدات
معالجة الرسوميات.
أحيانًا العشرات،
وأحيانًا الآلاف. لكن
تقسيم العمل يخلق
مشكلة جديدة. تحتاج
تلك الوحدات باستمرار
إلى تبادل أجزاء من
النموذج والنتائج
الوسيطة. إذا كان هذا
التبادل بطيئًا،
فسيقضي حتى أسرع معالج
وقتًا في الانتظار
أكثر من وقت الحساب.
وهذه هي المشكلة التي
صُمم نظام الرف لحلها.
فهو يضم وحدات معالجة،
ومعالجات مركزية،
وذاكرة، وشبكات تم
هندستها معًا كنظام
واحد. الاتصال بين
وحدات المعالجة أسرع
بكثير من شبكة مراكز
البيانات العادية. على
الرغم من أنه لا يزال
أبطأ من قراءة وحدة
المعالجة من ذاكرتها
الخاصة. واجهت Nvidia هذه
المشكلة منذ سنوات،
وأصبح حلها أحد أكبر
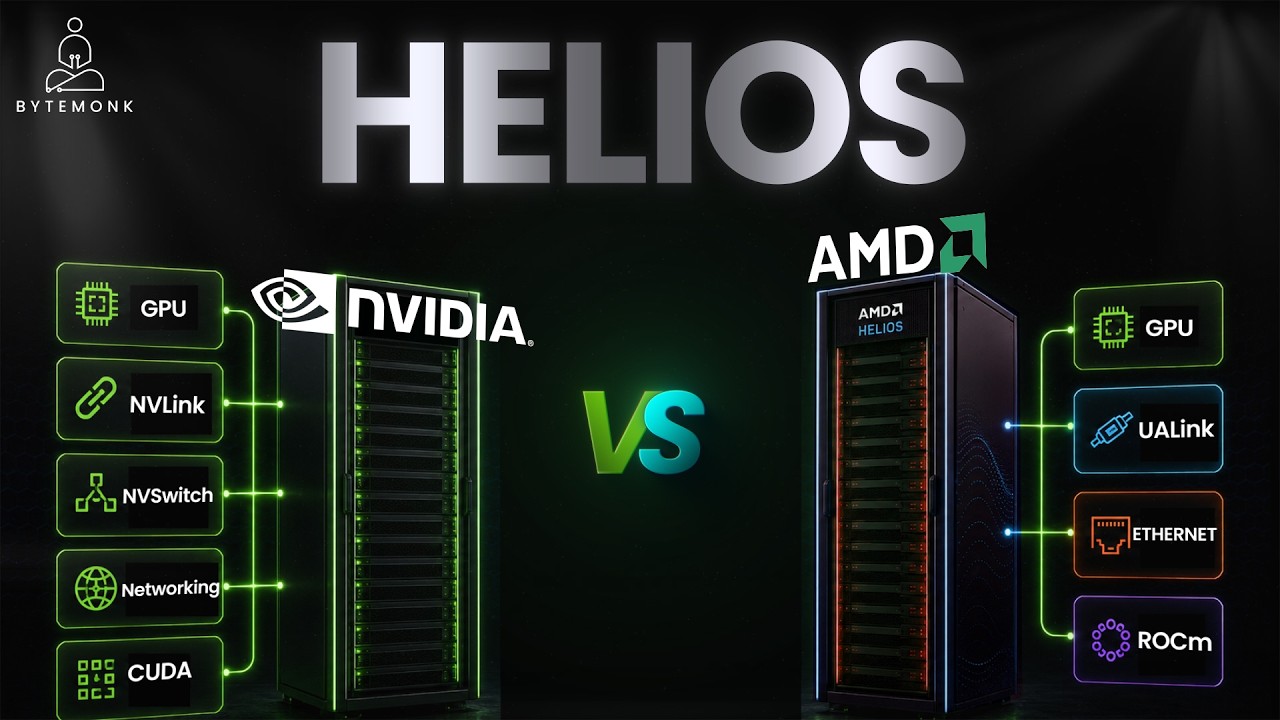
مزاياها. إجابة Nvidia
تسمى NVLink، وهو اتصال
مباشر عالي السرعة بين
وحدات المعالجة. أضف
محول NV وسيمكن لـ NVLink
ربط 72 وحدة معالجة في
مجموعة واحدة مترابطة
بإحكام. الآن، لا تصبح
وحدات المعالجة
حرفيًا وحدة واحدة،
لكن يمكن للبرمجيات
توزيع عبء العمل عليها
جميعًا دون الاعتماد
على شبكة عادية في كل
خطوة. وهذا ما يشغل
رفوف NVL72 من Nvidia. وهذا
جزء كبير من ميزة Nvidia
التنافسية. الأمر لا
يتعلق فقط بوحدة
المعالجة. تسيطر Nvidia
على وحدة المعالجة،
والوصلات البينية،
والمحولات، و CUDA،
وطبقة البرمجيات التي
تبني عليها بالفعل كل
فرق الذكاء الاصطناعي.
توفر Nvidia أيضًا
الشبكات التي تربط
رفًا بآخر. إذا اخترت
Nvidia، فمعظم أعمال
التكامل الصعبة تكون
قد أنجزت بالفعل من
أجلك. وهذا هو النظام
الذي تحاول AMD الآن
تحديه. "هيليوس" هو أول
تصميم مرجعي على مستوى
الرف من AMD. والآن، هذا
هو سبب أهمية المراجع.
لا تبيع AMD لك الحامل (
الراك) مباشرة. شركاء
مثل سوبر مايكرو و HP
يبنون الأنظمة
باستخدام مخططات AMD.
وهذا المخطط مبني حول
معايير مفتوحة بدلاً
من امتلاك AMD لكل قطعة.
لنبدأ بالحوسبة. حامل "
هيليوس" الواحد يحتوي
على 72 وحدة من وحدات
معالجة الرسومات
الجديدة Instinct MI250X من AMD
. كل واحدة منها تحمل
HBM4، وهو جيل جديد من
الذاكرة ذات النطاق
الترددي العالي
موضوعة بجانب وحدة
المعالجة مباشرة،
لتصل البيانات إليها
بسرعة. عبر الحامل
بأكمله، يصل ذلك إلى
حوالي 31 تيرابايت من
الذاكرة. وهذا أكثر
بنحو 50%مما يقدمه نظام
"فيرا روبين" القادم من
إنفيديا لكل وحدة
معالجة رسومات. هذا
مهم لأنك كلما احتفظت
بجزء أكبر من النموذج
داخل حامل واحد، قلّت
البيانات التي تحتاج
لنقلها بين الحوامل.
ونقل البيانات بين
الحوامل يكون أبطأ.
والآن، كيف تتواصل
وحدات معالجة
الرسومات الـ 72 هذه مع
بعضها البعض فعلياً؟
تستخدم AMD تقنية UALink،
وهي ليست نسخة مفتوحة
من NVLink، بل معيار ربط
منفصل بنته مجموعة
صناعية لحل المشكلة
نفسها. نقل البيانات
بسرعة بين المسرعات
داخل الحامل الواحد.
بين الحوامل، تتغير
المهمة. وهنا يأتي دور
شبكات Pensando التابعة لـ
AMD. إنها تستخدم
الإيثرنت مع دعم Ultra
Ethernet، وهي جهود صناعية
لجعل الإيثرنت يعمل
بشكل أفضل مع مجموعات
الذكاء الاصطناعي
الضخمة. داخل الحامل
توجد صواني خوادم أصغر
. كل صينية تربط أربع
وحدات معالجة رسومات
بواحدة من وحدات
المعالجة المركزية EPYC
الجديدة من AMD، والتي
تحمل الاسم الرمزي Venice
. تعمل وحدة المعالجة
المركزية كمضيف. فهي
تدير الذاكرة،
والتخزين، والشبكات،
وتدفق البيانات
اللازم لإبقاء وحدة
معالجة الرسومات
مشغولة. لم تكن AMD
لتتمكن من بناء حامل
كهذا باستخدام وحدات
معالجة الرسومات
وحدها. كانت بحاجة إلى
الشبكات، وتكامل
الحوامل، والبرمجيات.
وقد أمضت سنوات في
الاستحواذ على ما
يؤهلها لكل هذه
المجالات الثلاثة.
شركة Pensando، التي تم
شراؤها في 2022، جلبت
رقائق الشبكات التي
توجد الآن داخل كل
صينية في هيليوس. شركة
Zt Systems، التي تم شراؤها
في 2025، جلبت خبرة
تصميم ودمج كامل حوامل
الخوادم لأكبر شركات
السحابية في العالم.
استحواذات أصغر، بما
فيها not.ai و Mipsology، جلبت
خبرة إضافية في
برمجيات الذكاء
الاصطناعي بينما
استمرت AMD في تحسين ROCm،
بديلها مفتوح المصدر
لـ CUDA من إنفيديا. قد
يكون جزء البرمجيات
هذا هو أصعب جزء في
الرهان بأكمله. لقد
حظيت CUDA بسبق دام
عقداً من الزمن، ومعظم
فرق الذكاء الاصطناعي
قد بنت أدواتها حولها
بالفعل. يمكن أن يمتلك
الحامل أجهزة رائعة
ولكنه يفشل إذا كان
نقل عبء عمل حقيقي
إليه يتطلب شهوراً من
الهندسة الإضافية.
بناء الحامل كان نصف
المهمة فقط. السؤال
الأصعب كان دائماً عما
إذا كان أي شخص سيثق به
في بيئة الإنتاج. أكدت
مايكروسوفت للتو أن
خدمة Azure القادمة
ستستخدم "هيليوس"
لتشغيل نماذج الذكاء
الاصطناعي على نطاق
الإنتاج. كانت أوراكل
قد التزمت بالفعل بـ "
هيليوس" في وقت سابق.
انضمام مايكروسوفت
مهم بشكل خاص لأن Azure
تدير بعضاً من أكثر
أعباء عمل الذكاء
الاصطناعي تطلباً على
كوكب الأرض. هذا ليس
مجرد شراء لوحدة
معالجة رسوميات. نظام
مثل "هيليوس" يؤثر على
الطاقة، والتبريد،
والشبكات، والبرمجيات
في مركز البيانات
بالكامل. مايكروسوفت
مستعدة لبناء بنية
تحتية إنتاجية حوله،
وهذا يمثل اعترافاً
حقيقياً بقدرات AMD.
وهذا يخبرنا بما
يتنافس عليه نظام "
هيليوس" حقاً. ثم هناك
شركة أخرى تجعل قصة "
هيليوس" أكثر إثارة
للاهتمام، وهي OpenAI.
لدى OpenAI بالفعل
اتفاقية ضخمة مع شركة
AMD. تخطط الشركة لنشر
ما يصل إلى 6 جيجاوات
من وحدات معالجة
الرسوميات الخاصة بـ
AMD. ولكن هنا يكمن
الجزء المثير
للاهتمام. تعمل OpenAI
أيضاً على بناء
شريحتها الخاصة. تُسمى
"هابانيرو"، وقد تم
تطويرها بالتعاون مع
شركة برودكوم. إذن،
لماذا قد تبني OpenAI
شريحتها الخاصة بينما
لا تزال تشتري وحدات
معالجة رسوميات من AMD و
Nvidia؟ لفهم ذلك، نحتاج
إلى الفصل بين أمرين
نضعهما غالباً تحت
مسمى "حوسبة الذكاء
الاصطناعي". التدريب
والاستنتاج. التدريب
هو الوقت الذي نقوم
فيه ببناء النموذج
فعلياً. أنت تعالج
كميات هائلة من
البيانات وتحدث
مليارات المعلمات
مراراً وتكراراً.
يتطلب ذلك كميات ضخمة
من الحوسبة، والذاكرة
، واتصالاً فائق
السرعة بين وحدات
معالجة الرسوميات.
الاستنتاج هو ما يحدث
بعد تدريب النموذج.
أنت ترسل طلباً إلى
ChatGPT، فيولد النموذج
رموزاً، وهنا تصبح
أمور مثل زمن
الاستجابة،
والإنتاجية، وكفاءة
الطاقة مهمة للغاية.
وقد صُممت "هالابينيو"
خصيصاً لعبء عمل
الاستنتاج هذا. تقول
OpenAI إنها لم تكتفِ
بتصميم شريحة ثم بناء
خادم حولها. بل صممت
الشريحة، والذاكرة،
والشبكات، والبرمجيات
معاً بناءً على كيفية
تشغيل نماذج اللغة
الكبيرة فعلياً. لقد
نشرت OpenAI الآن أول
نتيجة قياس أداء
لشريحة "هالابينيو". في
اختبارها الخاص، سجلت
إنتاجية أفضل لكل
كيلووات وزمن استجابة
أقل مقارنة بالأنظمة
التجارية التي تمت
مقارنتها بها. لكن هذه
هي نتائج قياس الأداء
الخاصة بـ OpenAI، لذا لن
أعتبرها دليلاً على أن
"هالابينيو" ستحل فجأة
محل Nvidia. وشركة OpenAI
نفسها لا تفعل ذلك
أيضاً. فهي تقول إنها
ستواصل نشر المسرعات
من Nvidia وشركاء آخرين.
وفي الوقت نفسه، فهي
تشتري من AMD. ولأعباء
العمل التي تتطلب
تكاملاً أوثق بين
الأجهزة والبرمجيات،
فهي تبني أشباه موصلات
خاصة بها. إذن، قد لا
تكون هناك شريحة واحدة
فائزة لكل شيء في مجال
الذكاء الاصطناعي. قد
تستخدم شركة نظاماً
واحداً لتدريب
النماذج الرائدة،
وآخر للاستنتاج عالي
الإنتاجية، وأجهزة
متخصصة عندما تكون
الأولوية لزمن
الاستجابة أو كفاءة
الطاقة. وهذا يعيدنا
إلى ما يتنافس عليه
نظام "هيليوس" في
الواقع. وحدة معالجة
الرسوميات نفسها هي
مجرد جزء واحد من
النظام. إن كيفية
توصيل أشباه الموصلات
بمقياس الخادم الصحيح
، والذاكرة، والترابط
، والشبكات،
والبرمجيات، لا تقل
أهمية عن الشريحة
الموجودة في قلب
النظام. لقد بنت Nvidia
نظاماً متكاملاً
بإحكام تتحكم فيه في
معظم الطبقات المهمة.
وقد ساعد ذلك في ترسيخ
مكانة مهيمنة لها في
بنية الذكاء
الاصطناعي التحتية.
تراهن AMD مع مشروع Helios
على أنه إذا تحالفت
الصناعة حول معايير
مفتوحة، مثل الاعتماد
على Ethernet بدلًا من NVLink
، و ROCm بدلًا من CUDA،
فسيصبح كسر تلك الميزة
أسهل. مشروع Helios لا
يعني أن AMD قد لحقت بـ
Nvidia، لكنه يعني أن Nvidia
لديها أخيرًا منافس
جدي على مستوى الخوادم
، ومايكروسوفت مستعدة
لاستخدامه في الإنتاج.
مشروع Helios لا يعني أن
AMD لحقت بـ Nvidia، بل
يعني وجود بدائل. AMD
تنافس الآن على مستوى
وحدات الخوادم (الـ Rack)
. يقوم مقدمو الخدمات
السحابية ببناء
مسرعاتهم الخاصة،
وبدأت OpenAI في تصميم
عتاد مخصص لأحمال
عملها. لا تزال Nvidia
تمتلك أقوى نظام بيئي،
لكن البنية التحتية
للذكاء الاصطناعي لم
تعد تعتمد على وحدة
معالجة رسومية واحدة
تتفوق في كل شيء، بل
على أنظمة مختلفة
تتفوق في مهام مختلفة.
إذا أردتم تعمقًا أكبر
في كيفية عمل UALink و
UltraEthernet فعليًا،
اتركوا لي تعليقًا،
ولا تنسوا الإعجاب
والمشاركة والاشتراك
في القناة. دعمكم
المستمر يساعدني على
الاستمرار في صنع
الفيديوهات. شكرًا
للمشاهدة. أراكم في
الفيديو القادم.
Interactive Summary
Ask follow-up questions or revisit key timestamps.
يقدم الفيديو نظرة شاملة على "هيليوس" (Helios)، وهو أول خادم ذكاء اصطناعي متكامل من شركة AMD، والذي يمثل تحدياً مباشراً لهيمنة Nvidia في هذا المجال. يوضح الفيديو أهمية بناء أنظمة "على مستوى الرف" (Rack-scale) حيث لا تعتمد الكفاءة على قوة وحدة المعالجة فحسب، بل على سرعة الربط والشبكات والبرمجيات المتكاملة. كما يتناول الفيديو استراتيجية الشركات الكبرى مثل OpenAI التي تتبنى استراتيجية مزدوجة: شراء أنظمة من AMD وNvidia، مع تطوير شرائح مخصصة "هالابينيو" لمهام الاستنتاج، مما يشير إلى تحول في البنية التحتية للذكاء الاصطناعي نحو أنظمة متخصصة لكل مهمة بدلاً من حل واحد شامل.
Suggested questions
2 ready-made promptsRecently Distilled
Videos recently processed by our community